Тест практик backend: как оценить кандидата за 60 минут
Автор: Без автора
Тест практик backend — это готовый набор job‑релевантных задач и рубрика оценки, а не абстрактный алгоритмический экзамен. Работающая модель: короткий скрининг на реальном инженерном сценарии со стандартизированной рубрикой оценки. Такой тест сразу отсеивает кандидатов, чей опыт не совпадает с задачами роли, и экономит время старших инженеров на дальнейших этапах.
Кратко:
- Тесты для найма backend‑специалистов основаны на реальных задачах и стандартизированной оценочной рубрике, позволяя быстро отсеивать неподходящих кандидатов.
- Для каждой роли нужно учитывать профиль и ключевые навыки, такие как язык программирования, SQL, API-дизайн, безопасность и масштабируемость, избегая смешения архетипов.
- Форматы тестов включают короткий скрининг, удалённые задания и системное проектирование, при этом важно заранее уведомлять кандидатов и разрешать использование привычных инструментов.
- Оценка решений проводится по пяти осям: разложение задачи, чистота кода, объяснение решений, ясность коммуникации и инженерное чутьё, с калибровкой по реальным кандидатам.
- Адаптация тестов под конкретные стек и роль — важный этап, который лучше доверить специалистам, чтобы не терять сильных кандидатов и оптимизировать процесс найма.
Содержание
- Как описать профиль роли и выбрать навыки для теста
- Форматы тест практик: скрининг, take‑home и system design
- Рубрика оценки: оси, шкалы и калибровка проходного балла
- Встраивание теста в процесс найма: пайплайн и роли
- Практика Geekfactor: что показывает опыт работы с тестами
- Методики адаптации тестов под разные технологии и стеки
- Инструменты и платформы для создания и проведения тестов
- Типичные ошибки кандидатов и способы их выявления на тестах
- Что на самом деле определяет качество теста
- Как Geekfactor помогает внедрить тест практик backend
- Источники
- Часто задаваемые вопросы
Как описать профиль роли и выбрать навыки для теста
Тест начинается не с задачи, а с профиля. Если вы не зафиксировали, какой backend вам нужен, тест будет проверять случайный набор навыков и давать шум вместо сигнала.
Разделите роли на архетипы. API‑generalist пишет CRUD‑логику, работает с базами данных и интеграциями, закрывает большую часть типовых вакансий в продуктовых командах. Data‑layer инженер глубже разбирается в оптимизации запросов, индексах и миграциях схем. Infra/systems‑инженер отвечает за масштабируемость, отказоустойчивость и облачную инфраструктуру. Каждый архетип требует своего набора заданий, и смешивать их в одном тесте — частая ошибка.
Независимо от архетипа, есть зоны, которые нужно проверять почти всегда, поскольку они формируют минимальный технический профиль backend‑разработчика:
- владение серверным языком команды (Python, Node.js или Java — одни из наиболее часто используемых языков в отрасли);
- SQL и работа с реляционными базами, в том числе PostgreSQL как одной из самых распространённых СУБД;
- проектирование API: коды состояния, секционирование, обработка ошибок;
- базовая безопасность: валидация входных данных, аутентификация, защита от инъекций;
- понимание масштабируемости: кэширование, очереди, горизонтальное масштабирование.
Разбивку обязанностей по слоям backend удобно держать перед глазами при составлении заданий, чтобы не тестировать лишние навыки, не относящиеся к вакансии. Отдельно стоит проверять soft‑skills, которые редко попадают в чек‑листы: умение разложить задачу на шаги и объяснить, почему выбрано одно техническое решение, а не другое. Рекомендации по подбору навыков для backend‑ролей прямо указывают: тестировать нужно язык, SQL, API‑дизайн, безопасность и масштабируемость последовательно, а не всё сразу в одной задаче.
Форматы тест практик: скрининг, take‑home и system design
Формат теста определяет, что вы на самом деле измеряете. Есть три рабочих сценария, и каждый решает свою задачу в пайплайне найма.
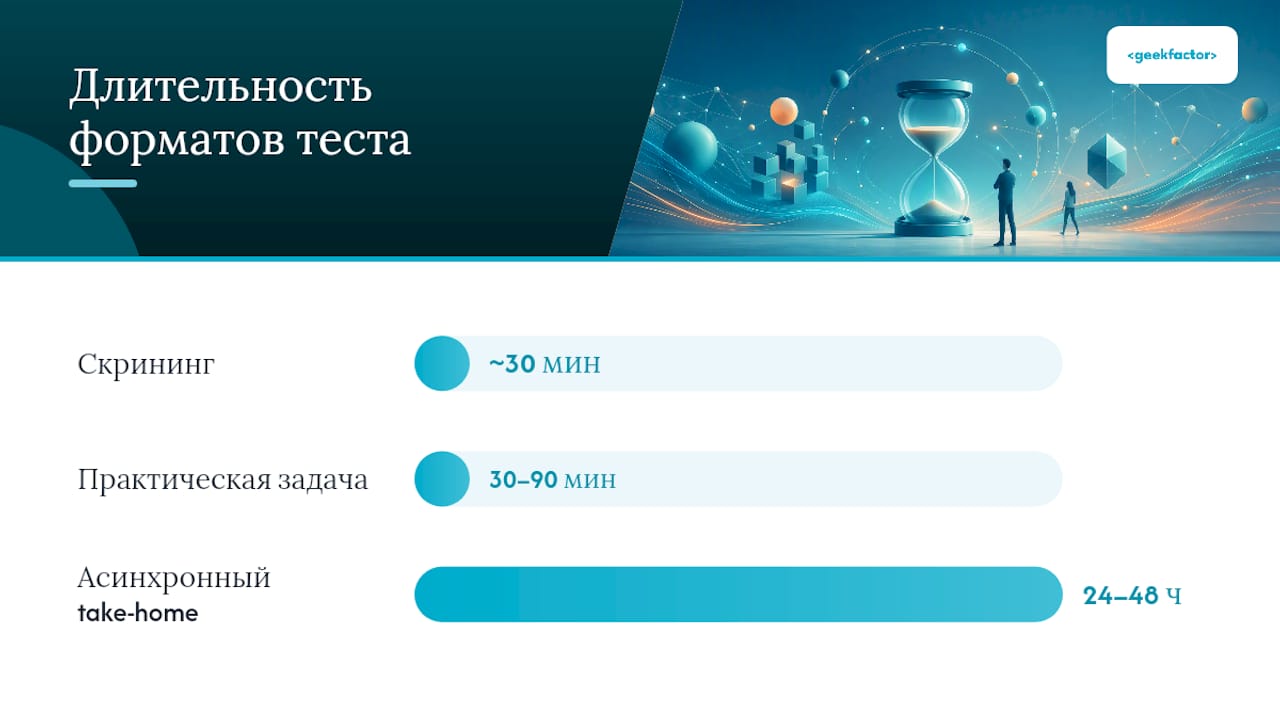
- Короткий скрининг (несколько десятков минут). Одна задача на базу данных (например, спроектировать схему для конкретного бизнес‑кейса), один API‑endpoint для реализации и один debugging‑сценарий с заранее сломанным кодом. Такой набор быстро показывает базовую техническую грамотность без затрат целого дня инженера.
- Асинхронное задание. Кандидат выполняет тест удалённо в течение фиксированного окна (например, 24–48 часов на выполнение при реальном времени работы 60–90 минут). Подходит, когда нужно проверить больше кандидатов параллельно.
- Take‑home и system design. Полноценная задача на проектирование системы, обычно на финальных этапах, где кандидат защищает архитектурные решения перед senior‑инженером.
Практические форматы заданий — схема БД, реализация endpoint, разбор багов — предсказывают рабочую производительность точнее, чем абстрактные алгоритмические головоломки. Они укладываются в 30–90 минут в зависимости от цели теста.
Есть два практических правила, которые заметно повышают качество сигнала. Формат теста стоит присылать кандидату за 24 часа заранее, чтобы он не терял время на угадывание условий. И разрешайте использовать привычные рабочие инструменты — IDE, документацию, поиск — потому что запрет на них измеряет память, а не инженерные навыки.
Профессиональный совет: Добавьте в конце любого формата вопрос «Что бы вы сделали, если бы у вас был ещё час?». Он отделяет кандидатов, которые видят границы своего решения, от тех, кто считает задачу полностью закрытой.
Рубрика оценки: оси, шкалы и калибровка проходного балла
Рубрика — это то, что превращает тест из субъективного впечатления в сопоставимые данные. Без письменной рубрики два интервьюера почти всегда расходятся в оценке одного и того же решения.
Рабочая модель строится на нескольких ключевых измеримых осях:
- decomposition — умение разбить задачу на шаги перед тем, как писать код;
- code fluency — техническая грамотность и чистота реализации;
- reasoning — способность объяснить trade‑offs между решениями;
- communication — насколько понятно кандидат формулирует свои действия;
- taste — чувство того, где остановиться, а где усложнить решение оправданно.
Каждая ось оценивается по шкале от 1 до 3, что даёт максимум 15 баллов при пяти осях или 12 баллов при четырёх. Шаблон рубрики с этими пятью измерениями предполагает проходной порог около 8 из 12 баллов для скринингового этапа.
Технические скрининги калибруются так, чтобы проходило среднее количество кандидатов, обеспечивая баланс между строгой и лояльной оценкой: если тест пропускает почти всех, порог слишком низкий; если почти никого, вы теряете сильных кандидатов из‑за перфекционизма рубрики.
Калибровку нельзя делать «на бумаге». Прогоните рубрику на 5–10 реальных кандидатах, сравните оценки разных интервьюеров по одному и тому же решению и скорректируйте формулировки осей там, где расхождение превышает один балл.
Встраивание теста в процесс найма: пайплайн и роли
Тест практик работает только внутри понятного пайплайна с чёткими ролями на каждом этапе.
- Резюме и первичный отбор. HR‑менеджер отсеивает кандидатов по формальным критериям: стек, опыт, локация.
- Скрининговый тест (несколько десятков минут). Отправляется автоматически или через HR сразу после первичного отбора, с форматом, известным кандидату заранее.
- Технический разговор (около 60 минут). Senior‑инженер разбирает решение теста, задаёт уточняющие вопросы по коду и логике.
- System design. Финальный этап для ролей, где архитектурные решения критичны для дальнейшей работы.
- Оффер. Решение принимается на основе совокупных баллов по рубрике, а не общего впечатления.
Роли распределяются логично: HR запускает тест, следит за таймлайном и коммуницирует с кандидатом, а оценивает решение по рубрике технический специалист, обычно senior engineer. Такая связка сокращает время найма и снижает риск ошибочных решений, потому что комбинация короткого теста и предметного интервью заменяет размытое общее собеседование конкретными проверяемыми данными.
Скорость отклика кандидату имеет значение не меньше, чем содержание теста: если результат приходит через две недели, сильные кандидаты уже приняли другое предложение. Частая ошибка — держать тест «на всякий случай» для всех вакансий подряд, вместо того чтобы адаптировать пайплайн под конкретный профиль роли.
Практика Geekfactor: что показывает опыт работы с тестами
За годы подбора backend‑специалистов в Geekfactor мы видели одну и ту же картину: компании, у которых есть готовая рубрика и job‑relevant тест, закрывают вакансии заметно быстрее тех, кто полагается на свободное собеседование.
Самый надёжный индикатор будущей производительности — не скорость написания кода, а то, начинает ли кандидат с уточняющих вопросов и декомпозиции задачи. Кандидаты, которые сначала проясняют условия, почти всегда справляются с реальными рабочими сценариями лучше остальных.
Мы регулярно помогаем компаниям адаптировать тест под конкретный стек и уровень роли, опираясь на кейсы из практики подбора и обратную связь от нанимающих менеджеров. Если вы хотите пересобрать тест под свою вакансию, опишите текущий процесс подбора, и мы предложим формат, который реально работает на вашем стеке.
Методики адаптации тестов под разные технологии и стеки
Один и тот же тест плохо подходит и для команды на Python с PostgreSQL, и для команды на Java с распределёнными очередями. Адаптация начинается с фиксации стека: язык, СУБД, ключевые библиотеки, облачная платформа.
Дальше меняется не суть заданий, а их обёртка. Задача на проектирование схемы БД остаётся задачей на проектирование схемы, но конкретные таблицы и связи стоит подбирать близко к домену компании: e‑commerce, финтех, логистика. Debugging‑сценарий для Node.js‑команды строится вокруг асинхронности и обработки промисов, а для команды на Java — вокруг многопоточности и управления памятью.
Для инфраструктурных ролей стоит добавлять элементы system design с реальными архитектурными паттернами: например, задачу на проектирование системы с использованием подхода retrieval‑augmented generation для команд, работающих с AI‑продуктами, или классическую задачу на очереди и шардирование для высоконагруженных сервисов.
Полезное правило: держите ядро рубрики неизменным (пять осей оценки), а меняйте только содержание заданий. Это позволяет сравнивать кандидатов на разные роли по единой шкале, даже если стек полностью различается.
Инструменты и платформы для создания и проведения тестов
Выбор инструмента зависит от того, какой формат теста вы используете. Для коротких скринингов подходят платформы с готовыми шаблонами задач и встроенным таймером, которые автоматически фиксируют время выполнения и активность кандидата. Для take‑home заданий чаще используют приватные репозитории с преднастроенным окружением, чтобы кандидат не тратил время на настройку проекта, а сразу решал бизнес‑задачу.
Для system design многие команды обходятся без специализированного софта: достаточно доски для схем и видеозвонка, где кандидат проговаривает решение вслух. Важнее инструмента здесь — заранее подготовленный список вопросов и критериев, по которым интервьюер будет оценивать архитектуру.
Общий обзор доступных подходов и инструментов для оценки IT‑кандидатов стоит держать под рукой при выборе платформы: сравнение инструментов оценки кандидатов помогает понять, какой вариант подходит именно вашему объёму найма. Компании с небольшим потоком кандидатов часто обходятся без платной платформы, ограничиваясь Git‑репозиторием и таблицей для рубрики. Компании с десятками вакансий в месяц выигрывают от автоматизации: платформа сама рассылает тест, собирает решения и агрегирует оценки нескольких интервьюеров.
Типичные ошибки кандидатов и способы их выявления на тестах
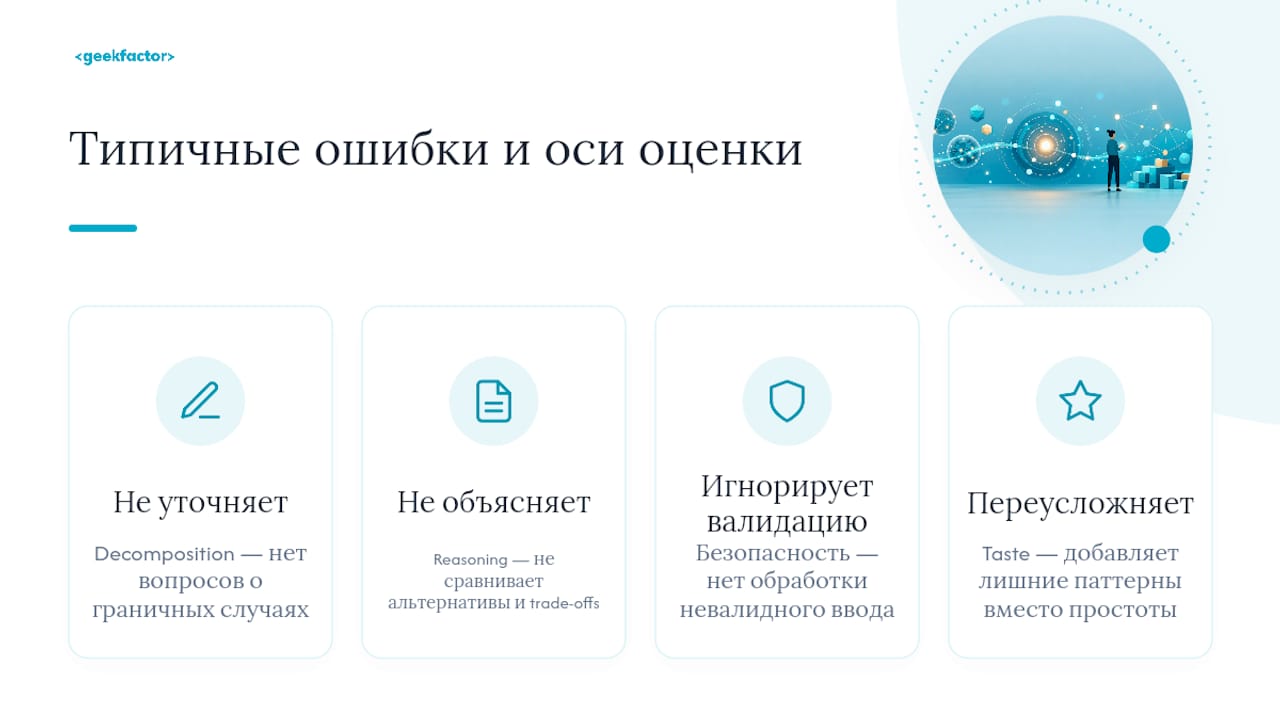
Есть несколько ошибок, которые повторяются у кандидатов почти на любом уровне, и рубрика должна ловить их системно, а не полагаться на интуицию интервьюера.
Первая — кандидат сразу пишет код, не уточнив требования и не проговорив план. Это заметно по оси decomposition: сильный кандидат тратит первые минуты на вопросы о граничных случаях, слабый сразу открывает редактор.
Вторая — решение работает, но кандидат не может объяснить, почему выбран именно такой подход. Это проверяется осью reasoning: попросите сравнить выбранное решение с альтернативой и назвать trade‑offs.
Третья ошибка — игнорирование безопасности и обработки ошибок. Кандидат пишет happy‑path код, который ломается при первом невалидном вводе. Отдельный пункт рубрики на обработку исключений и валидацию сразу вскрывает эту проблему.
Четвёртая — переусложнение простой задачи ради демонстрации знаний. Ось taste специально существует, чтобы отделить кандидатов с инженерным чутьём от тех, кто добавляет паттерны и абстракции там, где они не нужны.
Что на самом деле определяет качество теста
Большинство компаний тратит силы на поиск «идеальной» задачи, хотя формат задачи почти не влияет на качество сигнала. Решает рубрика: без письменных критериев два инженера, глядя на одно и то же решение, поставят разные оценки, и весь тест превращается в лотерею мнений.
Ещё одна распространённая ошибка — копировать чужой тест целиком, включая задачи под другой стек и другой уровень роли. Тест, который отлично работает для senior infra‑инженера, бессмысленно применять к джуниору на позицию API‑generalist: он либо провалит всё, либо не покажет ничего полезного о своих реальных навыках.
Приоритет должен быть таким: сначала зафиксировать архетип роли, потом собрать рубрику из пяти осей, и только затем подбирать конкретные задачи. Компании, которые начинают с задач, а рубрику дописывают «по ходу», обычно получают несопоставимые оценки уже через два.три собеседования.
— Kirill
Как Geekfactor помогает внедрить тест практик backend
Составление теста своими силами занимает недели: нужно определить архетип роли, собрать задания под стек, откалибровать рубрику на реальных кандидатах. Мы берём эту работу на себя как часть подбора и консалтинга по технической оценке, экономя вашей команде именно то время, которое обычно уходит на пробы и ошибки с самодельными тестами.
Услуга включает разработку теста под конкретную вакансию, готовую рубрику с проходным баллом и сопровождение на этапе оценки решений кандидатов. Начать можно с короткого аудита текущей вакансии: мы разбираем, какие навыки реально нужны на роли, и показываем пример готового задания под ваш стек. Оставьте заявку на странице для компаний, и мы предложим формат теста, который встанет в ваш пайплайн найма без лишней перестройки процесса.
Источники
- How to hire a backend developer | Testlify
- How to Design a Technical Screen That Actually Predicts Performance (2026)
- Hiring backend engineers: skills assessment & sourcing guide | daily.dev recruiter
Часто задаваемые вопросы
Что такое тест практик backend в найме?
Это готовый набор job‑релевантных заданий и рубрика оценки, которые проверяют реальные навыки кандидата: серверный язык, SQL, API‑дизайн, безопасность и масштабируемость.
Сколько должен длиться тест для скрининга?
Оптимальная длительность скринингового теста — несколько десятков минут, включая одну задачу на базу данных, один API‑endpoint и один debugging‑сценарий.
Кто должен оценивать результаты теста?
Запускает и коммуницирует тест HR‑менеджер, а оценивает решение по рубрике senior‑инженер, знакомый с техническими требованиями роли.
Можно ли адаптировать тест под нестандартный стек?
Да, ядро рубрики из пяти осей остаётся неизменным, а меняются только конкретные задания под язык, СУБД и архитектурные паттерны команды. Мы помогаем подобрать такой формат в рамках консультации по подбору специалистов.